Anthropic lanza programa de investigación sobre el bienestar de modelos IA
Anthropic abre una nueva línea de investigación dedicada al bienestar de los modelos de IA, explorando cómo garantizar que estos sistemas funcionen de manera segura y alineada con valores humanos. La iniciativa busca comprender mejor el comportamiento interno de Claude y otros modelos de lenguaje.
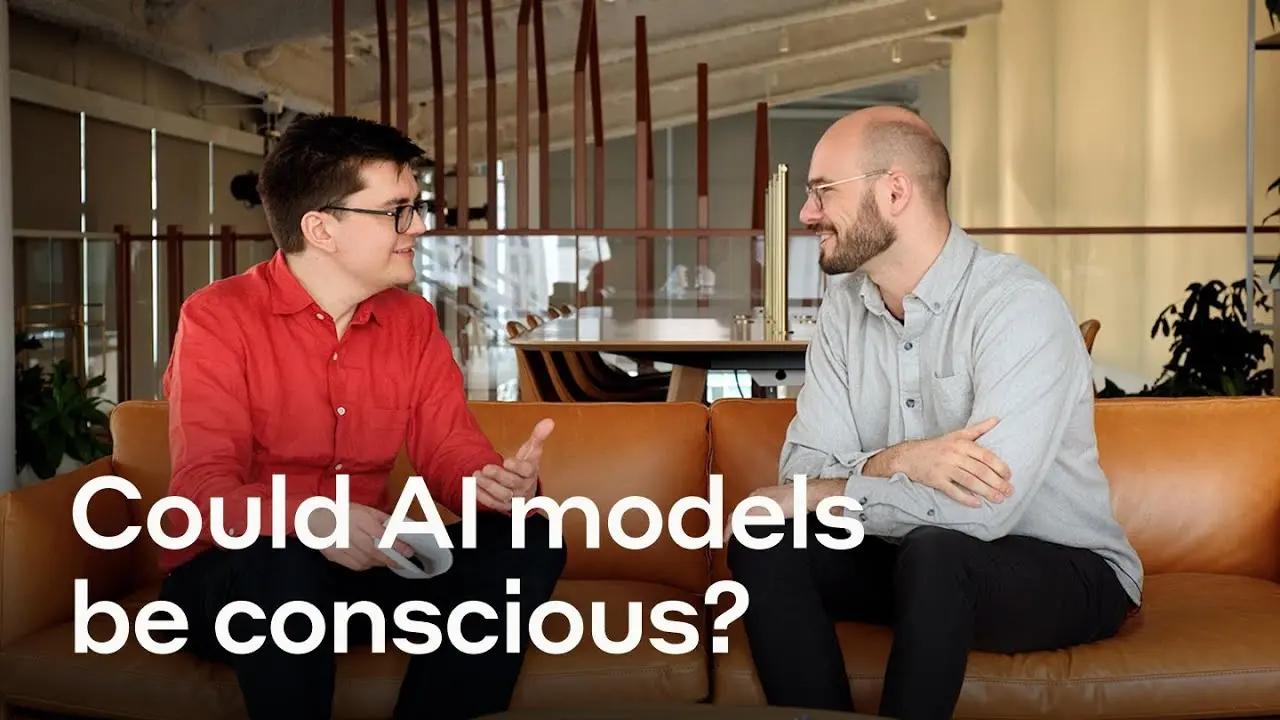
Anthropic ha anunciado el lanzamiento de un nuevo programa de investigación centrado en el «model welfare» (bienestar del modelo), una iniciativa que profundiza en cómo diseñar y monitorear sistemas de IA que se comporten de manera segura, predecible y alineada con los valores humanos.
Se trata de un área de estudio emergente en la seguridad de IA que va más allá de las métricas tradicionales de rendimiento. En lugar de solo medir precisión o velocidad, Anthropic examina el comportamiento interno de Claude durante el entrenamiento y la inferencia para entender cómo el modelo procesa información, toma decisiones y responde ante situaciones adversariales o ambiguas.
Qué hay detrás
El concepto de "model welfare" surge de la necesidad de entender qué ocurre dentro de la caja negra de los grandes modelos de lenguaje. A medida que Claude y sistemas similares se integran en aplicaciones críticas —desde análisis de datos en SAP hasta generación de informes financieros—, las organizaciones requieren garantías más profundas sobre cómo funcionan estos modelos bajo estrés, con datos sesgados o en contextos que no han visto durante el entrenamiento.
Este programa representa el compromiso de Anthropic con la seguridad de IA desde los fundamentos. No se trata solo de implementar guardrails externos, sino de comprender y optimizar el comportamiento del modelo en su esencia. La investigación incluye técnicas de interpretabilidad, estudios de robustez y métodos para identificar puntos débiles antes de que lleguen a producción.
Por qué te importa si trabajas con SAP
Para profesionales que integran Claude en ecosistemas SAP —ya sea mediante APIs, agentes autónomos o análisis de datos en S/4HANA—, esta investigación tiene implicaciones directas. Un modelo más predecible y robusto significa menos sorpresas en procesos críticos. Si usas Claude para automatizar flujos de trabajo, extracción de datos o asistencia en decisiones empresariales, saber que Anthropic invierte en entender cómo se comporta el modelo bajo diferentes condiciones incrementa la confianza en tu arquitectura.
Además, en contextos regulados o altamente sensibles (finanzas, cumplimiento normativo), la investigación en model welfare proporciona una base más sólida para justificar el uso de IA en decisiones que afectan al negocio.
¿Te ha resultado útil esta noticia?
Fuente original
Leer artículo originalSeguir leyendo
Hace 3 días
Claude diseña proteínas contra toxinas de escorpión
Anthropic ha utilizado Claude en un proyecto de investigación para diseñar minibinders —pequeñas proteínas que se adhieren a objetivos específicos— capaces de neutralizar neurotoxinas de escorpión. El experimento demuestra las capacidades del modelo en biología computacional y abre interrogantes sobre su aplicación en descubrimiento de fármacos.
Hace 1 semana
Claude resuelve el misterio de origen de la curva ECDSA
Anthropic ha publicado un análisis que explica finalmente el origen de P-256, uno de los estándares criptográficos más usados en el mundo y cuya procedencia ha sido desconocida durante décadas. El hallazgo tiene implicaciones para la confianza en la seguridad de sistemas críticos.
Hace 1 semana
Claude diseña circuitos cuánticos más eficientes
Anthropic ha demostrado que Claude puede diseñar circuitos cuánticos que superan las mejores versiones publicadas, en algunos casos por un orden de magnitud. El hallazgo abre nuevas posibilidades para optimizar algoritmos cuánticos complejos de forma autónoma.
¿Te ha servido? Recíbelo cada lunes
Un correo semanal con lo más relevante de Claude y SAP, en español y sin ruido. Suscríbete aquí abajo →